Плащането на 20 долара всеки месец за абонамент към ChatGPT или Claude започва да тежи, а рискът чувствителни лични файлове, медицински документи или служебен фирмен код да изтекат в облака плаши все повече хора. Решението вече е тук: собствен изкуствен интелект, работещ на 100% офлайн на вашето лично бюро.
1. Защо локалният AI е хитът на 2026 година?
Благодарение на програми с отворен код като Ollama и LM Studio, днес всеки може да свали най-добрите отворени модели (DeepSeek-R1, Meta Llama 3.3, Mistral) с 2 клика.
- 100% поверителност: Нито една буква от разговора ви не напуска твърдия диск. Без цензура, без записване на разговори за трениране на алгоритми.
- Работи без интернет: В самолета, в планината или при срив на доставчика.
- Без месечни такси: Купувате хардуера веднъж и го ползвате неограничено.
2. Видеопаметта (VRAM) е кралят: Защо обикновеният RAM не стига?
Най-честата грешка на ентусиастите е да си купят 64GB обикновена оперативна памет (DDR5) и да очакват светкавичен AI.
Големите езикови модели (LLM) изискват огромна пропускателна способност на паметта (Memory Bandwidth). Обикновената DDR5 памет предава данни със скорост около 60–80 GB/s. За сравнение, видеокартата (VRAM GDDR6X) работи със скорост от 500 до 1000+ GB/s!
Ако заредите модел във видеокартата, той ще отговаря със скорост 25–60 думи в секунда (по-бързо от човешко четене). Ако обаче моделът прелее в обикновената системна RAM памет, скоростта се срива до 1–2 думи в секунда (изнервящо бавно).
3. Размери на моделите: 7B, 14B, 32B или 70B параметри?
Числото „B“ означава милиарди параметри (тегла). Колкото по-голямо е числото, толкова по-умен и логичен е моделът, но толкова повече памет изисква:
| Размер на модела | Нужна видеопамет (VRAM) | Подходящи видеокарти | Ниво на интелигентност |
|---|---|---|---|
| 7B – 8B (Llama 3.1 8B) | 8 GB VRAM | RTX 3060 12GB, RTX 4060, Apple M1/M2 | Отличен за ежедневни въпроси, резюмета, преводи |
| 14B (DeepSeek / Qwen 14B) | 12 GB VRAM | RTX 3060 12GB, RTX 4070 12GB | Много силен в програмиране и логика |
| 32B (DeepSeek-R1 32B) | 20 – 24 GB VRAM | RTX 3090 24GB, RTX 4090 24GB | Сравним с най-добрите платени платени модели |
| 70B (Llama 3.3 70B) | 40 – 48 GB VRAM | Две свързани RTX 3090 / Mac Studio 64GB | Експертно ниво за научни анализи и сложен код |
4. Магията на квантизацията (Q4 срещу Q8)
Оригиналните модели са записани с 16-битова прецизност (FP16). Чрез процес, наречен квантизация (Quantization, GGUF формат), числата се компресират до 4 бита (Q4_K_M).
Това намалява нужния размер на паметта с цели 70%, докато моделът губи по-малко от 1% от реалната си точност! Затова 99% от домашните AI потребители зареждат 4-битови или 5-битови версии.
5. Примерни конфигурации за домашен AI
- Бюджетен шампион (Златният стандарт втора ръка): PC с видеокарта Nvidia GeForce RTX 3060 12GB. Това е най-евтиният начин да имате 12GB VRAM и да пускате модерни модели до 14 милиарда параметри за под 900 лв. общ бюджет.
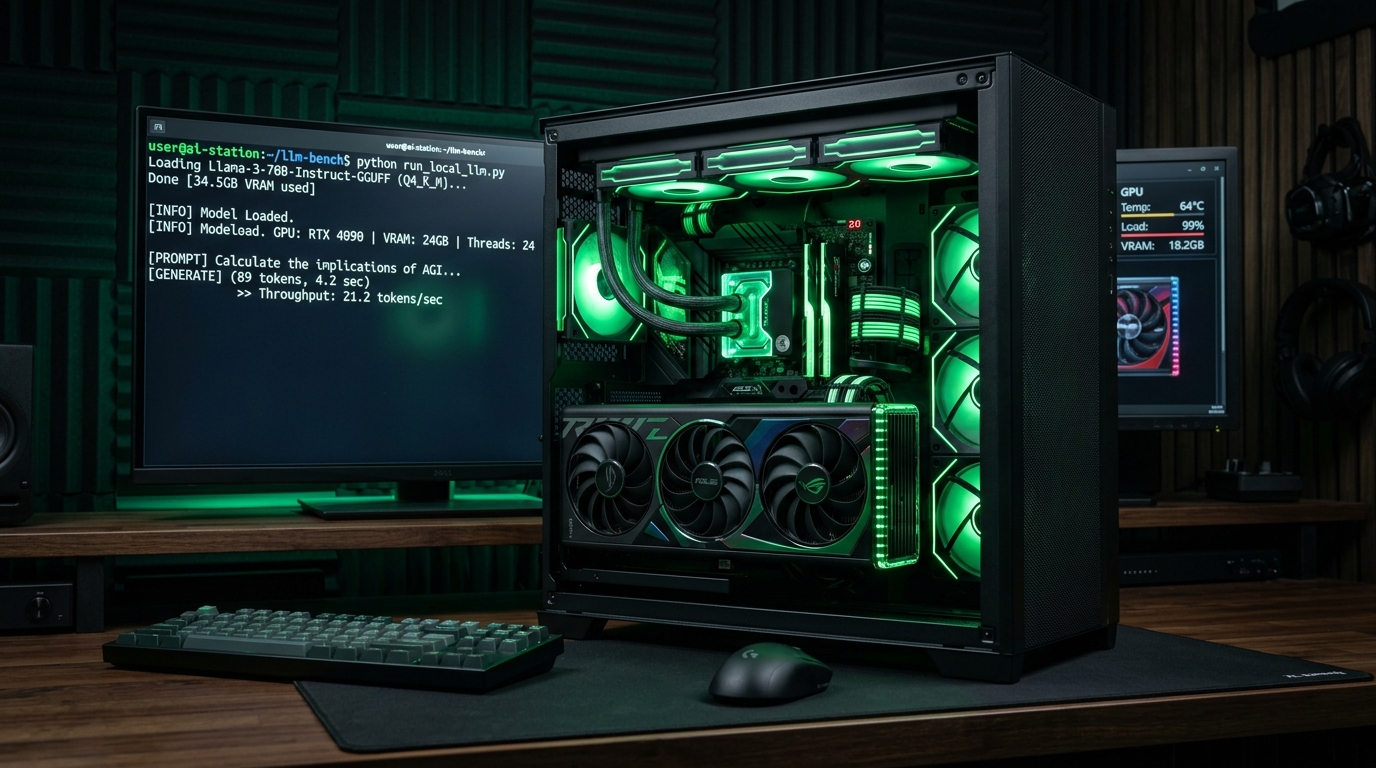
- Професионална работна станция: Процесор Ryzen 7/9, 64GB RAM и Nvidia RTX 4090 24GB (или втора употреба RTX 3090 24GB). Позволява локален DeepSeek-R1 32B със светкавична скорост и перфектно охлаждане.
Локалният AI товари видеокартата на 100% за дълги периоди от време. За разлика от игрите, тук паметта грее изключително силно. Сглобяването изисква качествено захранване с висок клас ефективност (Gold) и кутия с прецизен въздушен поток.
Често задавани въпроси по темата
Стават ли видеокартите на AMD Radeon за локален AI?
Възможно е през ROCm или Vulkan, но Nvidia с тяхната CUDA архитектура остава световният стандарт. При Nvidia всичко тръгва „от раз“ без сложни компилации.
Може ли да се ползва лаптоп за локален AI?
Да, стига лаптопът да има поне 8GB или 16GB VRAM, или да е Apple Mac със споделена памет (Unified Memory). Имайте предвид, че лаптопите загряват бързо при дълги сесии.
Колко ток харчи компютърът при работа с AI?
Само докато генерира отговор (обикновено 5 до 30 секунди), видеокартата тегли между 150W и 350W. През останалото време в покой машината харчи пренебрежимо малко (30W–40W).
Арсо Чангалов
Сервизен компютърен инженер & Основател на „Изправно“
С над 8 години опит в хардуерната диагностика, сглобяване и оптимизация на компютърни системи. Всяка статия тук е базирана на реални ремонти от моята ежедневна практика при посещения на адрес в град София.